Le déploiement automatisé avec Bitbucket et Bitbucket Pipelines
Une release ne doit pas être un événement, mais une routine. Comment, chez nous, un commit devient une version en service sans intervention manuelle, avec Git, Bitbucket et Bitbucket Pipelines.
Un logiciel n’est pas construit une fois puis laissé de côté. Il évolue tant qu’il est utilisé. Plus il y a de gestes manuels entre le code terminé et la plateforme en service, plus chaque modification coûte cher, et plus il est probable qu’une étape soit oubliée la centième fois. C’est pourquoi nous automatisons la livraison aussi loin que possible. Voici comment se déroule notre déploiement et quels outils y participent.
Ce dont un déploiement automatisé vous décharge
Un déploiement est la mise à disposition d’un logiciel sur un environnement. Classiquement, il comprend plusieurs étapes :
- Constituer la release
- Préparer la configuration pour l’environnement cible
- Créer le build et exécuter les tests automatisés
- Installer sur le système de recette
- Recette par les personnes utilisatrices
- Déployer en production
Tout ce qui ne nécessite pas de décision humaine est automatisé. Il reste la recette. Une release peut ainsi être installée par la personne qui a écrit la modification. Personne disposant de connaissances particulières ne doit intervenir. Et le chemin du staging vers la production est le même que celui de l’environnement de développement vers le staging.
Les termes en jeu : l’intégration continue (continuous integration) désigne la fusion et le test continus du code, la livraison continue (continuous delivery) une version livrable à tout moment, le déploiement continu (continuous deployment) la livraison sans déclenchement manuel.
Du commit à l’environnement
Tout commence par une modification du code : de nouveaux fichiers, des lignes modifiées, parfois une adaptation de la base de données. Le développement se fait dans son propre environnement. Les modifications sont regroupées dans un commit, poussé sur une branche du dépôt, et c’est précisément ce qui lance le pipeline.
Dans le pipeline, les tests automatisés s’exécutent en parallèle. Behat vérifie des scénarios basés sur le comportement, c’est-à-dire le déroulement du point de vue de la personne utilisatrice. PHPUnit vérifie les différents composants du code et leur interaction. Si un test échoue, la modification ne va pas plus loin.
Si le commit passe les tests, une pull request suit. Un deuxième membre de l’équipe relit le code et le valide ; ce n’est qu’ensuite qu’il est fusionné. Le merge déclenche le déploiement sur l’environnement correspondant. Pendant que le code et les données sont remplacés sur la branche cible, le système est brièvement indisponible, puis la nouvelle version tourne.
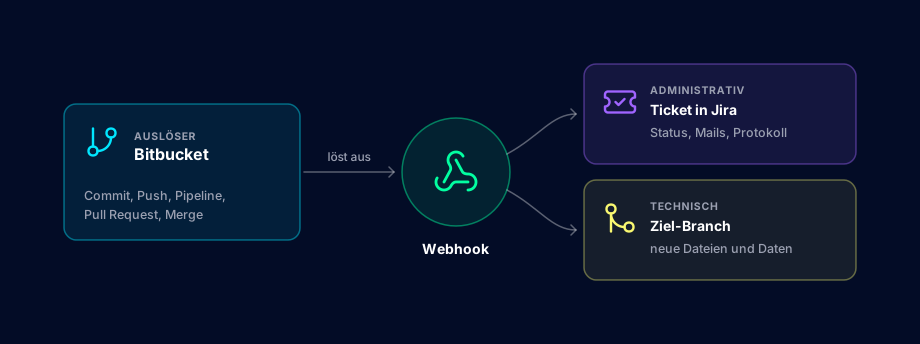
Trois outils portent le processus :
- Git pour la gestion des versions du code.
- Bitbucket pour les dépôts, commits, branches et pull requests.
- Bitbucket Pipelines pour les builds et les tests, lancés en parallèle à chaque commit.
Ce que cela apporte au quotidien
- Le processus est le même dans chaque projet, une release ne surprend plus personne.
- Moins d’étapes manuelles, c’est moins d’endroits où quelque chose peut mal tourner.
- Les déploiements sont plus courts, car rien n’est préparé à la main.
- L’équipe de développement n’est pas arrachée à son travail à chaque release.
- L’effort par release diminue, et avec lui les coûts.
Le processus fait partie de notre stack de plateforme et fonctionne partout de la même manière. Qui rejoint un projet y trouve le même pipeline que dans le précédent. C’est là le véritable gain de la standardisation.
 Rédigé par
Marc Christen
Senior Cloud Engineer / Software Developer