Architecture IA pour l’extraction de données dans OPAN®
Depuis l’été 2026, OPAN® lit les documents téléversés et propose les données dans le formulaire. Nous avons construit l’extraction de données sur des modèles exploités localement en Suisse : avec des schémas plutôt que le savoir des modèles, et avec une personne qui valide chaque valeur.
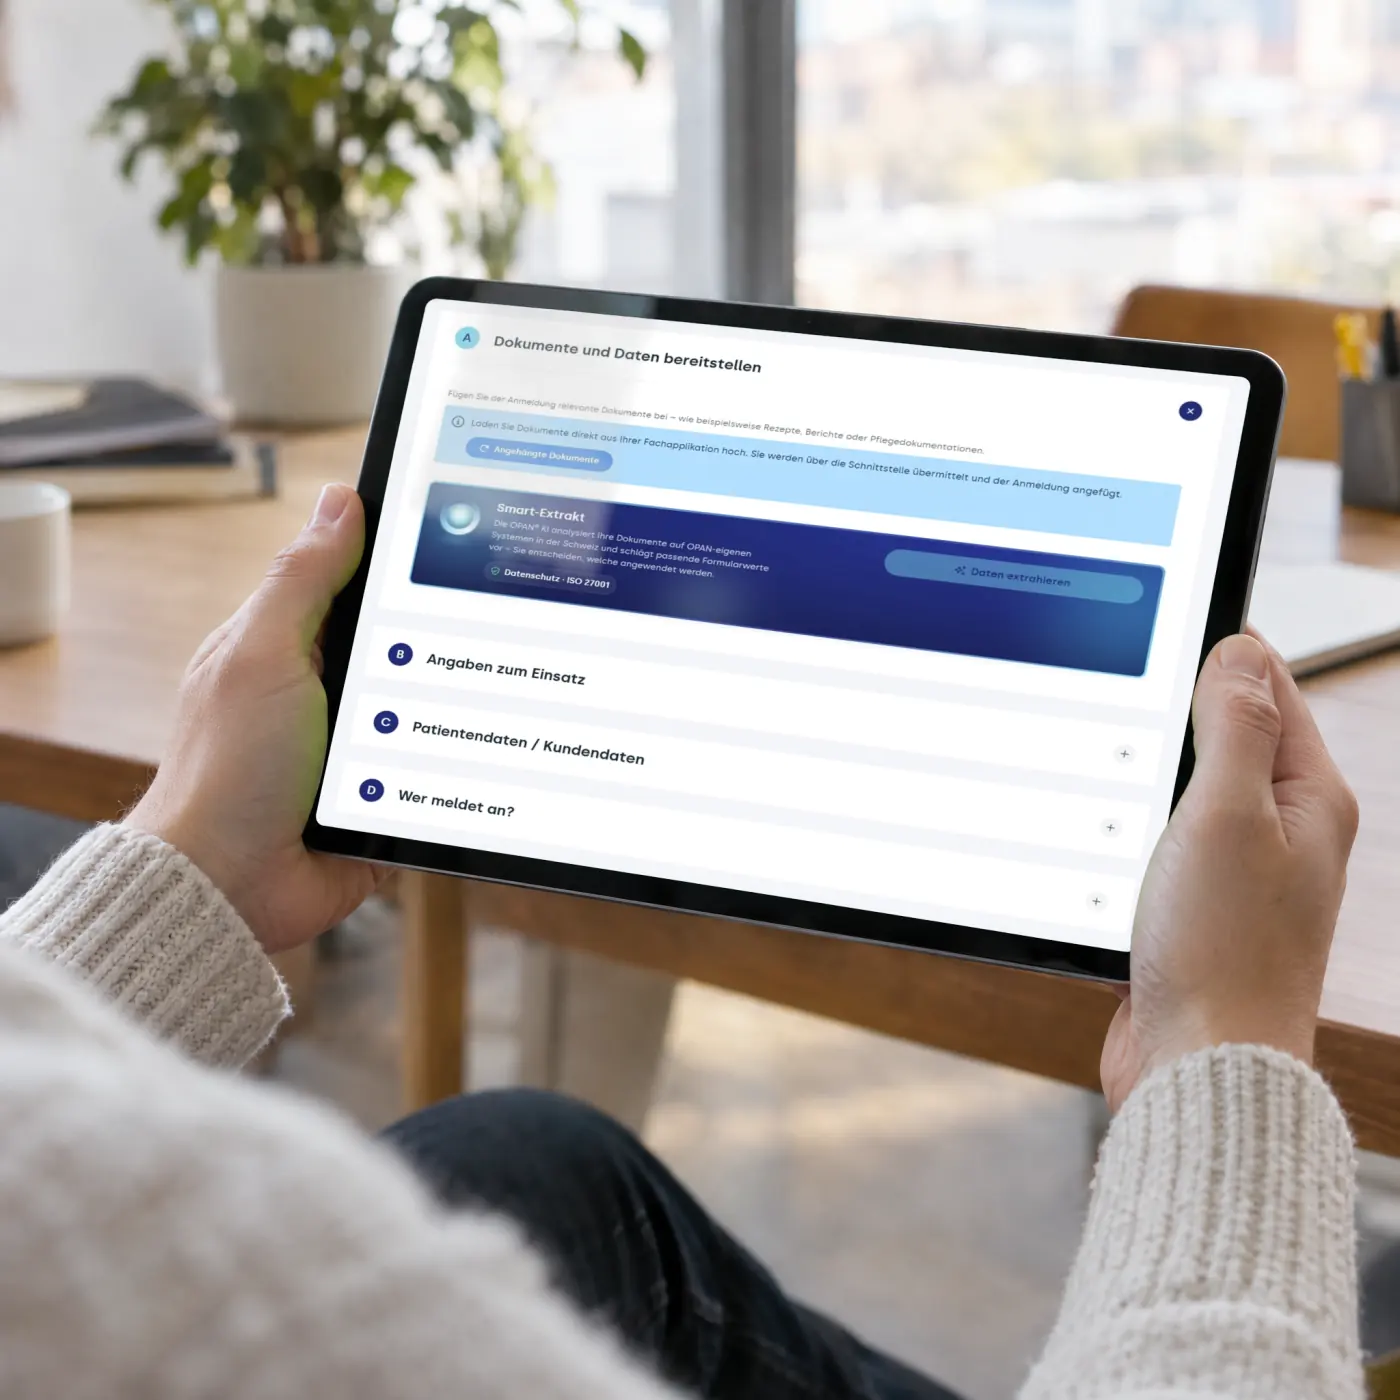
Via OPAN® transitent 97'000 annonces par an. Beaucoup de données nécessaires se trouvent déjà quelque part : dans le rapport de sortie, sur l’ordonnance, dans le système de l’hôpital. Jusqu’ici, quelqu’un les retapait. Cela prend du temps et produit des erreurs qui ne se remarquent que lorsque les soins ont commencé depuis longtemps.
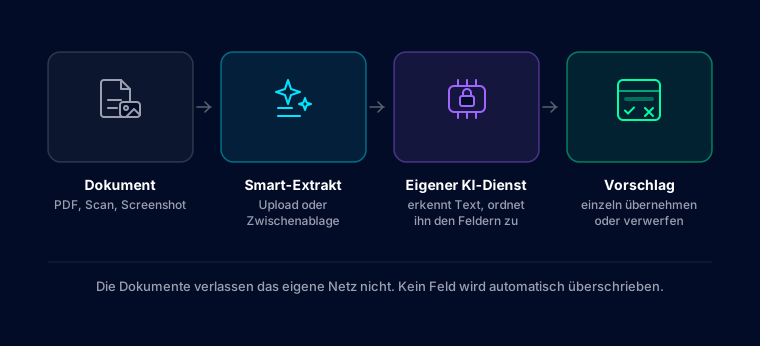
Depuis l’été 2026, OPAN® permet d’activer l’extraction de données, que nous appelons Smart-Extrakt. Lorsqu’elle est activée, la personne qui fait l’annonce décide pour chaque annonce si elle l’utilise : elle téléverse par exemple le rapport de sortie et lance l’extraction. Celle-ci lit le document, reconnaît les données nécessaires à l’annonce et les reporte dans les champs correspondants du formulaire.
La qualité des données y gagne doublement. Les données viennent directement de la source plutôt que du clavier. Et ce qui manque dans le document apparaît dans le formulaire comme une lacune, avant que l’annonce ne parte chez le prestataire de soins.
Des suggestions, pas d’automatisme
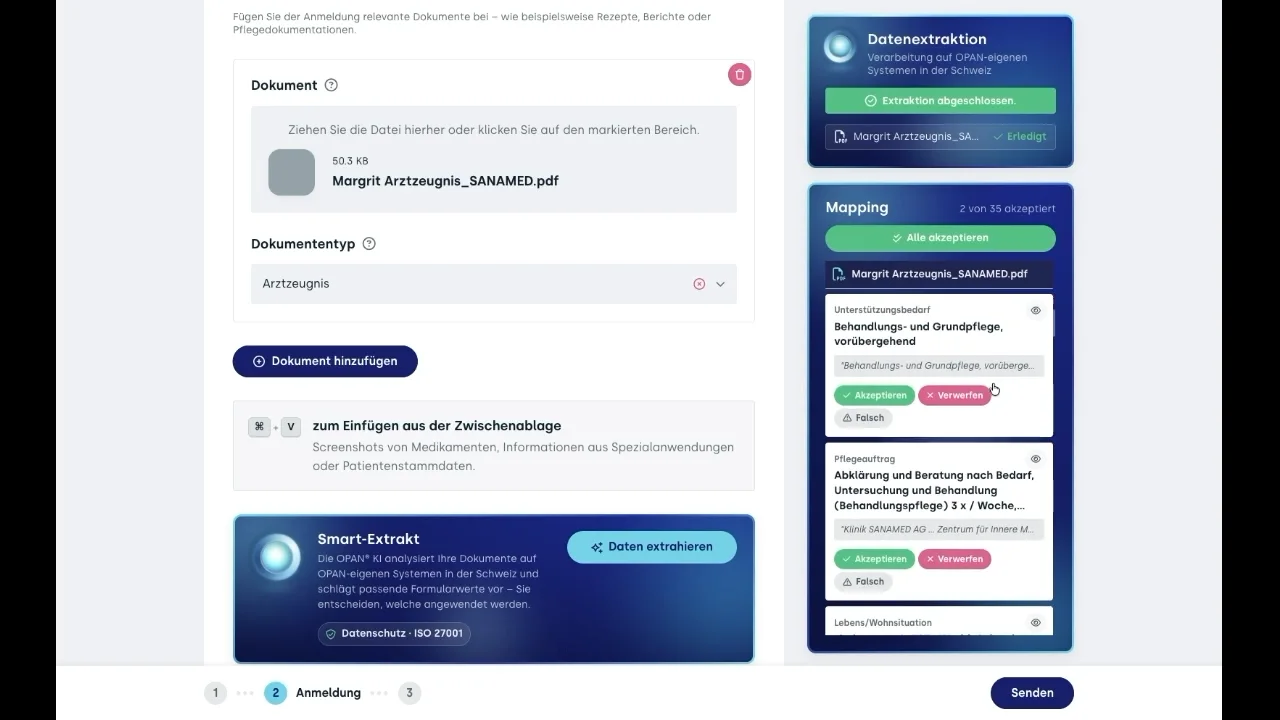
Le contrôle reste à deux endroits entre les mains de la personne qui fait l’annonce : au déclenchement et à la validation. Les valeurs extraites sont des suggestions. Elles figurent dans le formulaire, sont vérifiées, corrigées si nécessaire et seulement ensuite validées. Chaque suggestion peut être reprise ou rejetée individuellement, et ce qui a été repris est consigné dans le journal. Aucun champ n’est écrasé automatiquement. Le traitement décharge du travail, pas de la responsabilité.
Les organisations activent elles-mêmes la fonction. Celles qui n’en veulent pas travaillent comme avant. Pour des données de santé, une date de naissance reprise par erreur n’est pas un défaut cosmétique, d’où cette retenue.
Un pipeline par format d’entrée
Le point de départ n’est pas un modèle, mais une répartition selon l’origine des données. Les documents téléversés ou transmis via API vont dans le Document Processor, les captures d’écran passent d’abord par l’Image Processor. Les livraisons structurées provenant d’UPI, d’API et de FHIR sont prises en charge par le JSON Processor. Pour les établissements qui adressent des patientes et patients avec leur propre schéma de champs, un Custom Mapper s’y ajoute.
Cette séparation est voulue. Une capture d’écran nécessite un traitement d’image, un bundle FHIR non. Envoyer les deux dans le même traitement, c’est perdre soit en précision dans le cas structuré, soit en robustesse dans le cas non structuré.
Le super-ensemble de données
Tous les pipelines aboutissent à la même étape : l’extraction selon des schémas et des règles définis, exécutée par des modèles et des agents interchangeables. En interne, nous appelons le résultat le super-ensemble de données, l’état le plus structuré possible d’un dossier.
La logique métier se trouve dans les schémas et les règles, pas dans le modèle. Les données nécessaires à une annonce Spitex ou à une demande de réadaptation relèvent d’un savoir propre à chaque type de soins et n’ont pas leur place dans les poids d’un modèle. Nous pouvons ainsi remplacer un modèle par un meilleur sans réécrire les règles d’extraction.
S’y ajoutent des services qui enrichissent les données et en vérifient la plausibilité : requêtes VEKA, annuaires HIN, géocoordonnées, normalisation des adresses et des désignations. Une partie de la qualité des données ne vient pas des modèles de langage, mais de la comparaison avec des registres fiables.
Ce qui repose sur le dossier structuré
Un dossier structuré permet de construire des fonctions qui ne fonctionnent pas de manière fiable sur du texte libre. Sont en développement le résumé de dossier par IA, un contrôle de plausibilité et d’exhaustivité avant l’envoi, un chat sur le dossier, des traductions de documents et des analyses assistées par IA. Nous les déployons progressivement, une partie en phase bêta avec une sélection de clients et clientes.
La deuxième voie est plus importante qu’il n’y paraît : les prestataires de soins peuvent récupérer les données structurées via l’API et les traiter dans leur propre environnement. Qui exploite sa propre IA, pour le triage, le reporting ou le préremplissage dans son système, reçoit une base de données propre plutôt qu’une interface de plus. OPAN® n’a pas besoin d’être l’endroit où se fait chaque traitement par IA.
Du matériel dédié en Suisse
Nous exploitons le traitement par IA sur du matériel dédié à haute performance, GPU compris, en Suisse, avec des modèles de langage hébergés localement qui n’envoient d’eux-mêmes aucune donnée sur Internet. C’est une décision de protection des données avant d’être une décision technique. Une annonce contient des données personnelles sensibles. Si elles partent chez un fournisseur de modèles externe, la sous-traitance, le lieu de traitement et la limitation de la finalité dépendent de ses conditions. S’y ajoute le cadre organisationnel : l’exploitation se fait dans le même environnement certifié ISO/IEC 27001 que nos plateformes.
Le prix de cette décision, c’est l’effort. Nous développons nous-mêmes les pipelines, les schémas d’extraction et l’exploitation, sans recourir à une suite d’IA toute faite. En contrepartie, nous orientons le traitement sur le processus de transfert plutôt que sur un cas d’usage général, et nous décidons nous-mêmes quel modèle intervient à quel moment. La page L’IA dans le stack montre quelles autres fonctions d’IA le stack contient.
L’extraction de données en pratique
Le traitement devient particulièrement solide lorsque les deux voies se rejoignent. Via l’interface, les données de base du système d’information hospitalier arrivent dans le formulaire. Dans les documents fournis, l’extraction va chercher le contexte, c’est-à-dire les données sur l’évolution et les besoins pour lesquelles il n’existe pas de champ d’interface, et les place dans les champs prévus.
Là où les deux sources se recoupent, les mêmes données sont vérifiées deux fois. Là où l’interface ne fournit rien, le document complète.
 Rédigé par
Cédric Müller
Fullstack Software Developer