KI-Architektur für die Datenextraktion in OPAN®
Seit Sommer 2026 liest OPAN® hochgeladene Dokumente aus und schlägt die Angaben im Formular vor. Wir haben die Datenextraktion auf lokal betriebenen Modellen in der Schweiz gebaut: mit Schemata statt Modellwissen und mit einer Person, die jeden Wert freigibt.
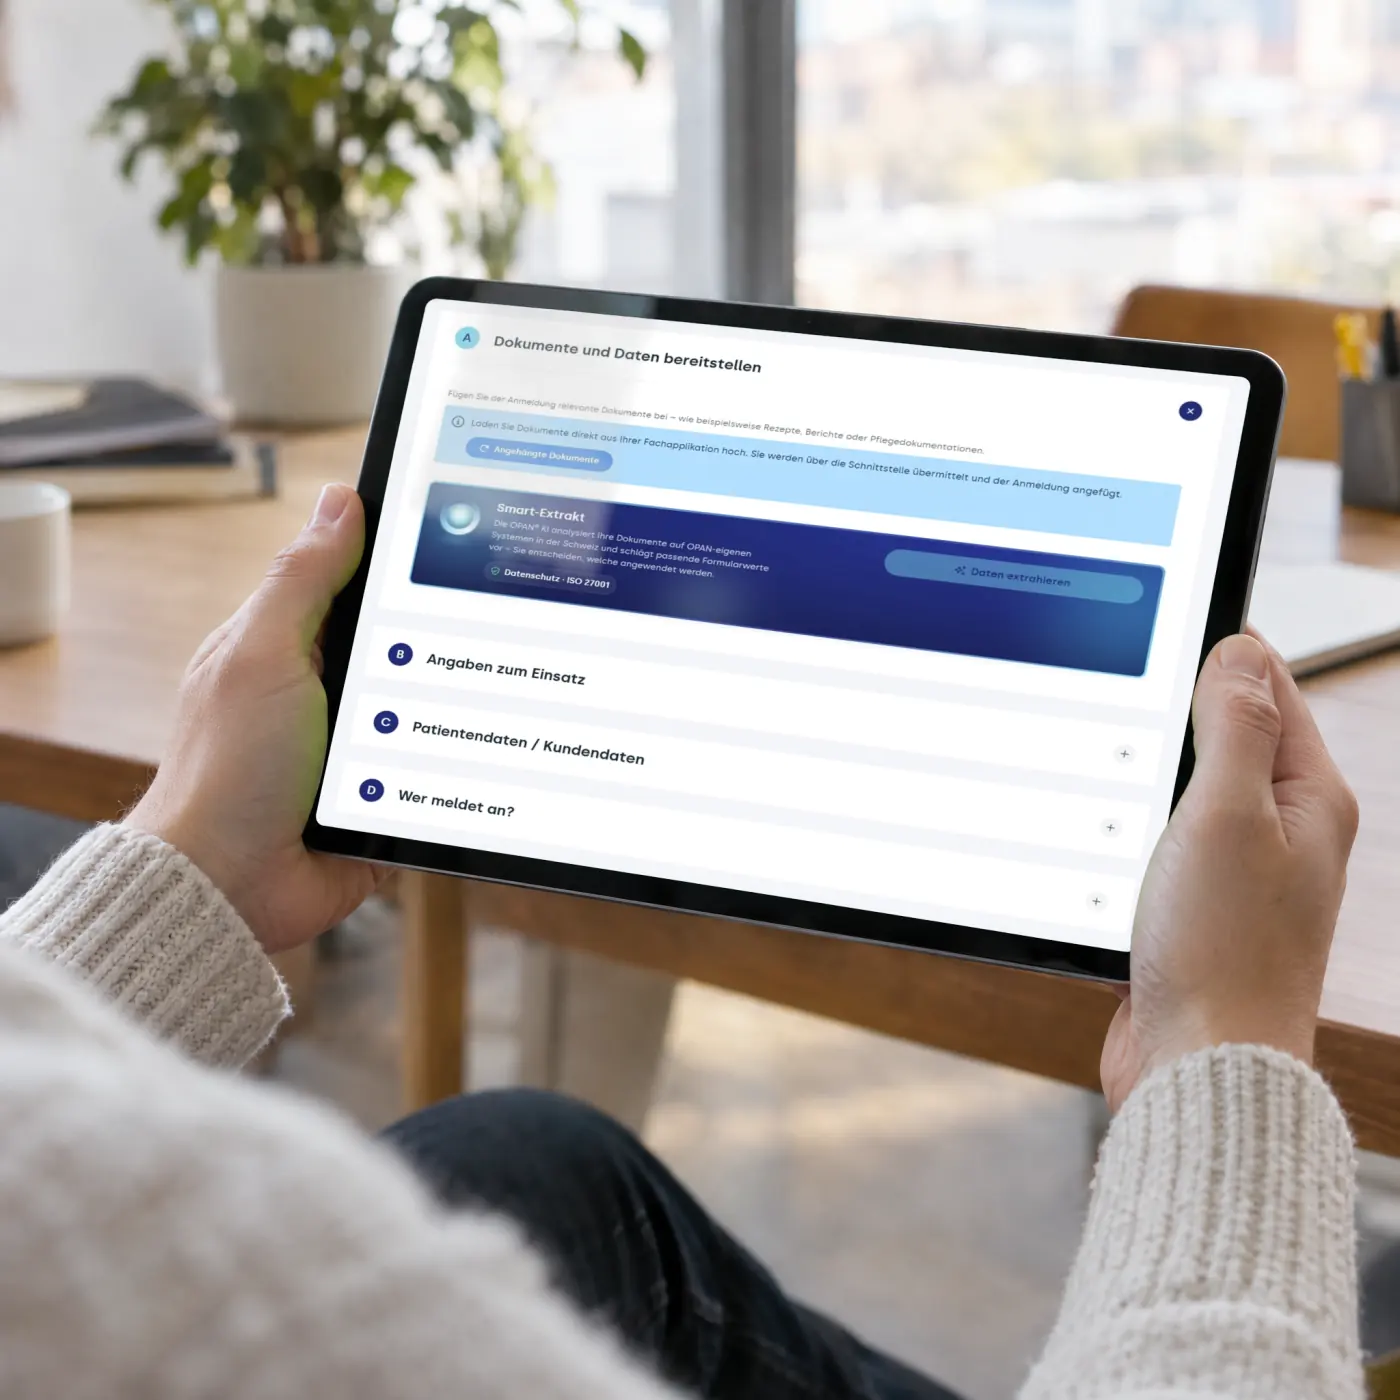
Über OPAN® laufen 97'000 Anmeldungen pro Jahr. Viele Angaben, die dafür gebraucht werden, stehen schon irgendwo: im Austrittsbericht, auf der Verordnung, im System des Spitals. Bisher hat jemand sie abgetippt. Das kostet Zeit und erzeugt Fehler, die erst auffallen, wenn die Pflege längst läuft.
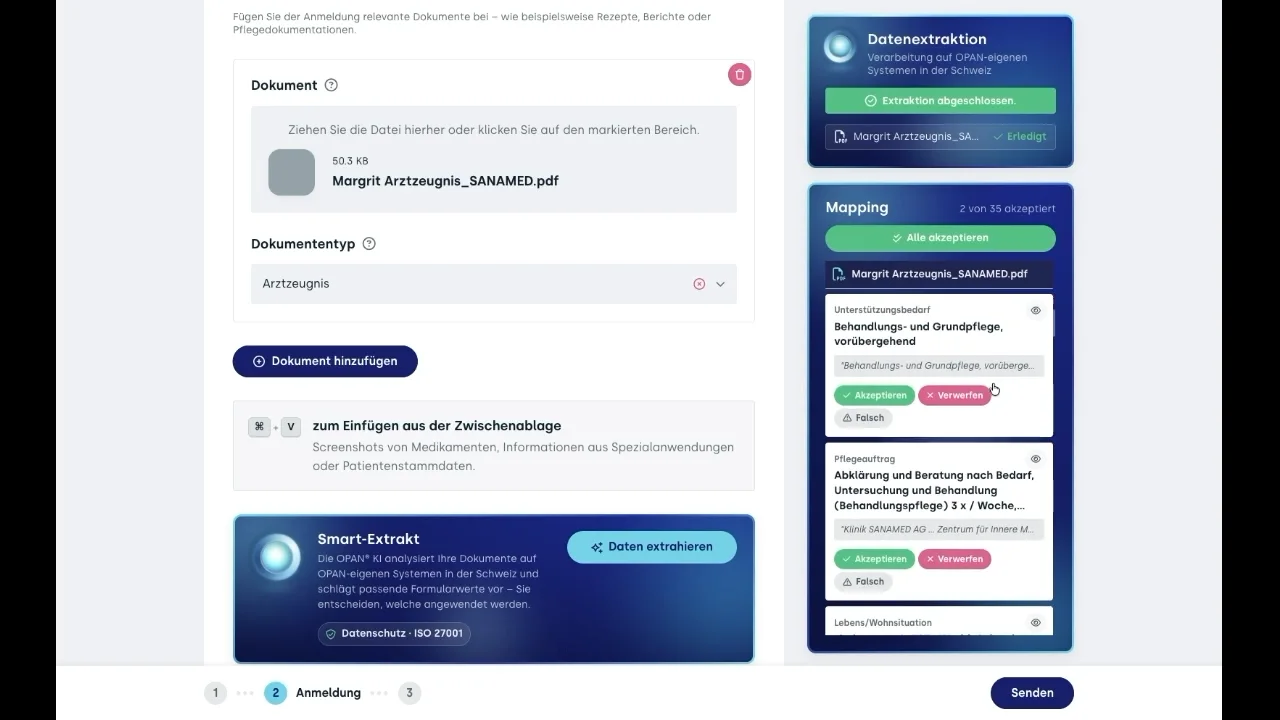
Seit Sommer 2026 lässt sich in OPAN® die Datenextraktion aktivieren, bei uns Smart-Extrakt. Ist sie eingeschaltet, entscheidet die anmeldende Person pro Anmeldung, ob sie sie einsetzt: Sie lädt zum Beispiel den Austrittsbericht hoch und startet die Extraktion. Diese liest das Dokument aus, erkennt die Angaben, die für die Anmeldung gebraucht werden, und überträgt sie in die passenden Felder des Formulars.
Das hebt die Datenqualität doppelt. Angaben kommen direkt aus der Quelle statt von der Tastatur. Und was im Dokument fehlt, erscheint im Formular als Lücke, bevor die Anmeldung an den Leistungserbringer geht.
Vorschläge, keine Automatik
Die Kontrolle bleibt an zwei Stellen bei der anmeldenden Person: beim Auslösen und beim Freigeben. Extrahierte Werte sind Vorschläge. Sie stehen im Formular, werden geprüft, bei Bedarf korrigiert und erst dann freigegeben. Jeder Vorschlag lässt sich einzeln übernehmen oder verwerfen, und was übernommen wurde, steht im Protokoll. Kein Feld wird automatisch überschrieben. Die Verarbeitung nimmt Arbeit ab, nicht die Verantwortung.
Organisationen schalten die Funktion selbst frei. Wer sie nicht will, arbeitet wie bisher. Bei Gesundheitsdaten ist ein falsch übernommenes Geburtsdatum kein Schönheitsfehler, deshalb diese Zurückhaltung.
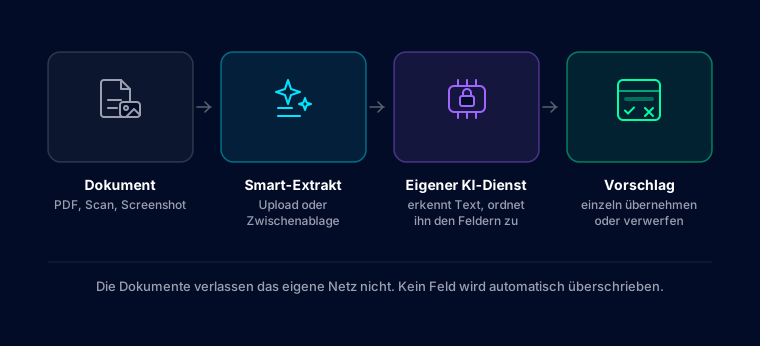
Pro Eingangsformat eine Pipeline
Am Anfang steht nicht ein Modell, sondern eine Aufteilung nach der Herkunft der Daten. Dokumente, die hochgeladen oder per API übermittelt werden, gehen in den Dokument-Processor, Screenshots vorher durch den Image-Processor. Strukturierte Lieferungen aus UPI, API und FHIR nimmt der JSON-Processor auf. Für Zuweiser mit eigenem Feldschema kommt ein Custom Mapper dazu.
Diese Trennung ist Absicht. Ein Screenshot braucht Bildverarbeitung, ein FHIR-Bundle nicht. Wer beides durch dieselbe Verarbeitung schickt, verliert entweder Präzision beim strukturierten Fall oder Robustheit beim unstrukturierten.
Das Daten-Super-Set
Alle Pipelines münden im selben Schritt: Extraktion gegen definierte Schemata und Regeln, ausgeführt von austauschbaren Modellen und Agenten. Das Ergebnis nennen wir intern das Daten-Super-Set, den maximal strukturierten Stand eines Falls.
Die Fachlogik liegt in den Schemata und Regeln, nicht im Modell. Welche Angaben eine Spitex-Anmeldung braucht und welche eine Reha-Anfrage, ist versorgungsspezifisches Wissen und gehört nicht in Modellgewichte. So tauschen wir ein Modell gegen ein besseres, ohne die Extraktionsregeln neu zu schreiben.
Dazu kommen Dienste, die Angaben anreichern und auf Plausibilität prüfen: VEKA-Abfragen, HIN-Verzeichnisse, Geokoordinaten, die Normalisierung von Adressen und Bezeichnungen. Ein Teil der Datenqualität entsteht nicht durch Sprachmodelle, sondern durch den Abgleich mit verlässlichen Registern.
Was auf dem strukturierten Fall aufsetzt
Aus einem strukturierten Fall lassen sich Funktionen bauen, die auf Freitext nicht zuverlässig laufen. In Entwicklung sind die KI-Fallzusammenfassung, eine Plausibilitäts- und Vollständigkeitsprüfung vor dem Absenden, ein Fall-Chat, Dokumentenübersetzungen und KI-gestützte Auswertungen. Wir rollen sie schrittweise aus, ein Teil davon in einer Beta-Phase mit ausgewählten Kunden.
Der zweite Weg ist wichtiger, als er aussieht: Leistungserbringer können die strukturierten Daten über die API abholen und in ihrer eigenen Umgebung weiterverarbeiten. Wer selbst KI betreibt, für Triage, Reporting oder Vorbefüllung im eigenen System, erhält eine saubere Datengrundlage statt einer weiteren Oberfläche. OPAN® muss nicht der Ort sein, an dem jede KI-Verarbeitung stattfindet.
Dedizierte Hardware in der Schweiz
Wir betreiben die KI-Verarbeitung auf dedizierter Hochleistungs-Hardware inklusive GPUs in der Schweiz, mit lokal gehosteten Sprachmodellen, die von sich aus keine Daten ins Internet schicken. Das ist eine Datenschutzentscheidung, bevor es eine technische ist. In einer Anmeldung stehen besonders schützenswerte Personendaten. Gehen sie an einen externen Modellanbieter, hängen Auftragsbearbeitung, Ort der Verarbeitung und Zweckbindung an dessen Bedingungen. Dazu kommt der organisatorische Rahmen: Der Betrieb läuft im selben ISO/IEC-27001-zertifizierten Umfeld wie unsere Plattformen.
Der Preis dieser Entscheidung ist Aufwand. Pipelines, Extraktionsschemata und Betrieb entwickeln wir selbst, wir nutzen keine fertige KI-Suite. Dafür richten wir die Verarbeitung auf den Zuweisungsprozess aus statt auf einen allgemeinen Anwendungsfall, und wir bestimmen selbst, welches Modell wann zum Einsatz kommt. Welche weiteren KI-Funktionen im Stack stecken, zeigt die Seite KI im Stack.
Datenextraktion in der Praxis
Besonders tragfähig wird die Verarbeitung, wenn beide Wege zusammenkommen. Über die Schnittstelle gelangen die Stammdaten aus dem KIS ins Formular. Aus den mitgelieferten Dokumenten holt die Extraktion den Kontext dazu, also die Angaben zu Verlauf und Bedarf, für die es kein Schnittstellenfeld gibt, und setzt sie in die vorgesehenen Felder.
Wo sich beide Quellen überschneiden, werden dieselben Angaben doppelt geprüft. Wo die Schnittstelle nichts liefert, ergänzt das Dokument.
 Geschrieben von
Cédric Müller
Fullstack Software Developer