Nous développons notre propre expertise en IA
Début 2025, nous avons décidé d’exploiter l’IA nous-mêmes plutôt que de seulement l’acheter : avec notre propre infrastructure, notre propre savoir-faire et trois champs d’application concrets que nous mettons en place d’ici fin 2025.
Une grande partie de notre clientèle travaille dans la santé, dans des associations ou dans des secteurs soumis à des exigences strictes. Ses données sont sensibles et ne doivent pas quitter notre réseau pour être traitées dans un service tiers. Acheter des services d’IA tout faits serait la voie la plus rapide. Mais elle ne correspond pas à ce que nous promettons pour l’hébergement : des données en Suisse, sous notre contrôle.
Pourquoi nous exploitons l’IA nous-mêmes
C’est pourquoi, début 2025, nous avons formé un groupe de travail et décidé d’exploiter les modèles nous-mêmes : des modèles ouverts sur notre propre infrastructure, dans le même réseau que les plateformes. Au début, cela prend plus de temps qu’un contrat avec un fournisseur. En contrepartie, nous savons pour chaque requête où elle est traitée, et nous pouvons remplacer un modèle sans que la clientèle ait quoi que ce soit à changer.
La deuxième raison, c’est le savoir-faire. Qui se contente d’acheter de l’IA n’apprend pas comment elle se comporte, où elle échoue et ce qu’elle coûte. Nous voulons le savoir avant de la recommander à notre clientèle.
Trois champs pour commencer
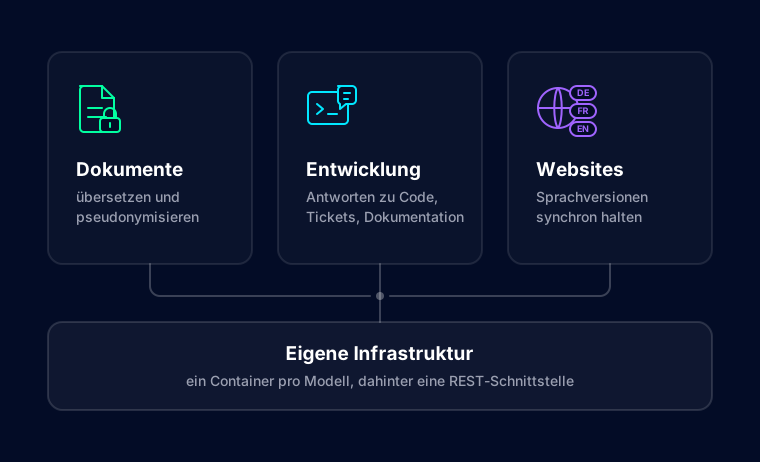
- Documents dans le domaine de la santé : traduire et pseudonymiser des rapports et des ordonnances, pour que les spécialistes aient moins à retaper et que les données personnelles restent protégées.
- Un assistant pour le développement : répondre aux questions sur le code, les tickets et la documentation, avec des réponses issues de nos propres connaissances plutôt que d’internet.
- Sites web multilingues : maintenir des contenus synchronisés en plusieurs langues, avec la terminologie propre à chaque client.
Comment nous construisons
Chaque modèle tourne dans son propre conteneur et est accessible via une interface REST. Les applications ne connaissent que cette interface, pas le modèle qui se trouve derrière. Quand un meilleur modèle devient disponible, nous remplaçons le conteneur, et rien d’autre. Les fonctions elles-mêmes, nous les ancrons dans le cloudtec Stack, pour qu’elles soient à la disposition de chaque plateforme qui tourne dessus.
D’ici fin 2025, nous voulons que l’infrastructure soit en place et qu’une fonction soit en service dans chacun des trois champs. Nous rendrons compte des premiers résultats ici, sur le blog.
Post-scriptum : ce qu’il en est advenu
Nous avons écrit cet article avant la grande vague des agents de codage. Le plan d’alors reste valable : l’infrastructure est en place, et toutes les fonctions d’IA tournent aujourd’hui sur notre propre serveur d’IA dans le réseau interne.
C’est avec Stack 2.2 que nous avons surtout misé sur les fonctions de texte. Le Writing Assistant de Stack CMS traduit, reformule, raccourcit et corrige directement dans l’éditeur, en respectant le registre et le glossaire de chaque mandant. Chaque résultat apparaît comme une suggestion, la rédaction décide. À quoi cela ressemble au quotidien, c’est ce que montre la page L’IA dans le stack. Et dans OPAN® la fonction d’extraction de données transforme un document photographié en dossier.
 Rédigé par
Christian Knellwolf
CEO