Wir bauen eigene KI-Kompetenz auf
Anfang 2025 haben wir entschieden, KI selbst zu betreiben, statt sie nur einzukaufen: mit eigener Infrastruktur, eigenem Fachwissen und drei konkreten Anwendungsfeldern, die wir bis Ende 2025 aufbauen.
Ein Grossteil unserer Kunden arbeitet im Gesundheitswesen, in Verbänden oder in Branchen mit strengen Vorgaben. Ihre Daten sind sensibel und dürfen unser Netz nicht verlassen, um in einem fremden Dienst verarbeitet zu werden. Fertige KI-Dienste einzukaufen wäre der schnellere Weg. Er passt nur nicht zu dem, was wir beim Hosting versprechen: Daten in der Schweiz, unter unserer Kontrolle.
Warum wir KI selbst betreiben
Deshalb haben wir Anfang 2025 eine Arbeitsgruppe gebildet und entschieden, die Modelle selbst zu betreiben: offene Modelle auf eigener Infrastruktur, im selben Netz wie die Plattformen. Das kostet zu Beginn mehr Zeit als ein Vertrag mit einem Anbieter. Dafür wissen wir bei jeder Anfrage, wo sie verarbeitet wird, und können ein Modell austauschen, ohne dass ein Kunde etwas ändern muss.
Der zweite Grund ist Fachwissen. Wer KI nur einkauft, lernt nicht, wie sie sich verhält, wo sie versagt und was sie kostet. Wir wollen das wissen, bevor wir sie Kunden empfehlen.
Drei Felder zum Start
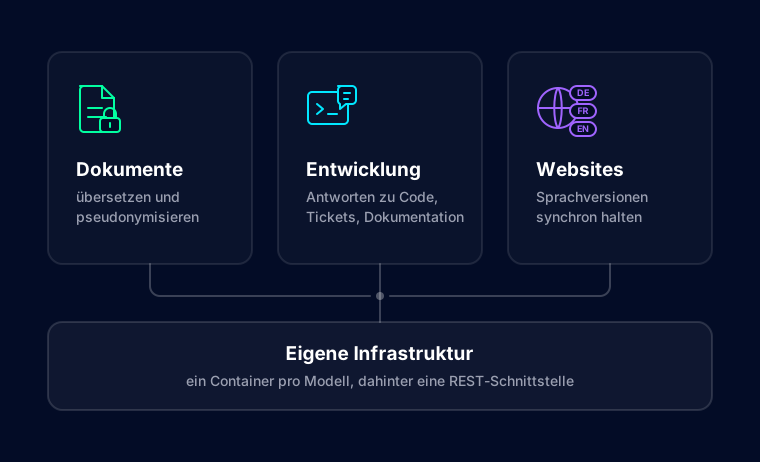
- Dokumente im Gesundheitswesen: Berichte und Verordnungen übersetzen und pseudonymisieren, damit Fachpersonen weniger abtippen und Personendaten geschützt bleiben.
- Ein Assistent für die Entwicklung: Fragen zu Code, Tickets und Dokumentation beantworten, mit Antworten aus dem eigenen Wissen statt aus dem Internet.
- Mehrsprachige Websites: Inhalte in mehreren Sprachen synchron halten, mit der Terminologie des jeweiligen Kunden.
Wie wir bauen
Jedes Modell läuft in einem eigenen Container und ist über eine REST-Schnittstelle erreichbar. Die Anwendungen kennen nur diese Schnittstelle, nicht das Modell dahinter. Wird ein besseres Modell verfügbar, tauschen wir den Container und sonst nichts. Die Funktionen selbst verankern wir im cloudtec Stack, damit sie jeder Plattform zur Verfügung stehen, die darauf läuft.
Bis Ende 2025 wollen wir die Infrastruktur stehen haben und in allen drei Feldern eine Funktion im Einsatz. Über die ersten Ergebnisse berichten wir hier im Blog.
Nachtrag: was daraus geworden ist
Geschrieben haben wir diesen Beitrag vor dem grossen Schub der Coding-Agenten. Der Plan von damals gilt trotzdem: Die Infrastruktur steht, und alle KI-Funktionen laufen heute auf dem eigenen KI-Server im internen Netz.
Mit dem Stack 2.2 haben wir vor allem auf Textfunktionen gesetzt. Der Writing Assistant im Stack CMS übersetzt, formuliert um, kürzt und korrigiert direkt im Editor, im Ton und Glossar des jeweiligen Mandanten. Jedes Ergebnis erscheint als Vorschlag, die Redaktion entscheidet. Wie das im Alltag aussieht, zeigt die Seite KI im Stack. Und in OPAN® macht die Datenextraktion aus einem fotografierten Dokument ein Dossier.
 Geschrieben von
Christian Knellwolf
CEO