Solr Search : fonctions, intégration et exemples d’utilisation
Apache Solr est la recherche plein texte de notre stack : auto-hébergée, largement configurable et rapide. Ce qu’elle sait faire, où elle tourne chez nous et à quel endroit les choses se sont corsées.
Une recherche qui ne trouve rien est plus agaçante que pas de recherche du tout. C’est pourquoi nos plateformes ne contiennent pas une requête de base de données qui compare des mots, mais un moteur de recherche à part entière : Apache Solr.
Ce qu’est Solr Search
Solr est une plateforme de recherche basée sur Apache Lucene. Nous avons intégré cette application open source dans notre stack et l’utilisons dans tous nos projets.
Solr tourne comme application autonome dans sa propre instance Docker sur notre infrastructure. Aucune donnée des bases de données des projets ne part donc chez des tiers, et les données personnelles restent elles aussi dans le système.
Une fois l’instance en place, les bases de données des différents projets y sont connectées ; elles fournissent les contenus de l’index. Les objets consultables par la recherche sont définis par projet : personnes, contrats, documents, pages. Nous définissons aussi l’affichage des résultats par type d’objet : pour un contrat, d’autres champs passent au premier plan que pour une personne.
Ce que Solr apporte d’origine
Solr parcourt les données connectées comme une recherche plein texte étendue. Ces fonctions sont incluses sans effort supplémentaire :
- Classement des résultats selon la fréquence et la précision du terme recherché
- Formes des mots : qui cherche « mots » trouve aussi « mot »
- Tolérance aux umlauts : une saisie sans umlaut trouve aussi les résultats avec umlaut
- Tolérance aux fautes de frappe et aux saisies incomplètes
- Mots vides : les mots de remplissage comme « comment puis-je » sont exclus de l’analyse, la recherche porte sur le reste
- Indexation rapide, pour que les nouveaux contenus soient immédiatement trouvables
- Temps de réponse stables même avec de nombreuses requêtes simultanées
Ce que nous avons ajouté
- Classement par titre : si le terme recherché figure dans le titre d’un objet, le résultat remonte
- Séparation des langues : les résultats n’apparaissent que dans la langue active
- Affichage des résultats selon le rôle d’autorisation
La liste n’est pas exhaustive ; pour certains projets, nous ajoutons d’autres fonctions.
Rendre les documents consultables
S’y ajoute Apache Tika. Ce parseur lit le texte des fichiers et rend ainsi leur contenu trouvable lui aussi : Word, Excel, PDF et d’autres formats. Cela vaut la peine partout où des formulaires, des notices ou des règlements sont joints sous forme de fichiers et où les gens cherchent le contenu, pas le nom du fichier.
Où nous utilisons Solr
Suisse Rando
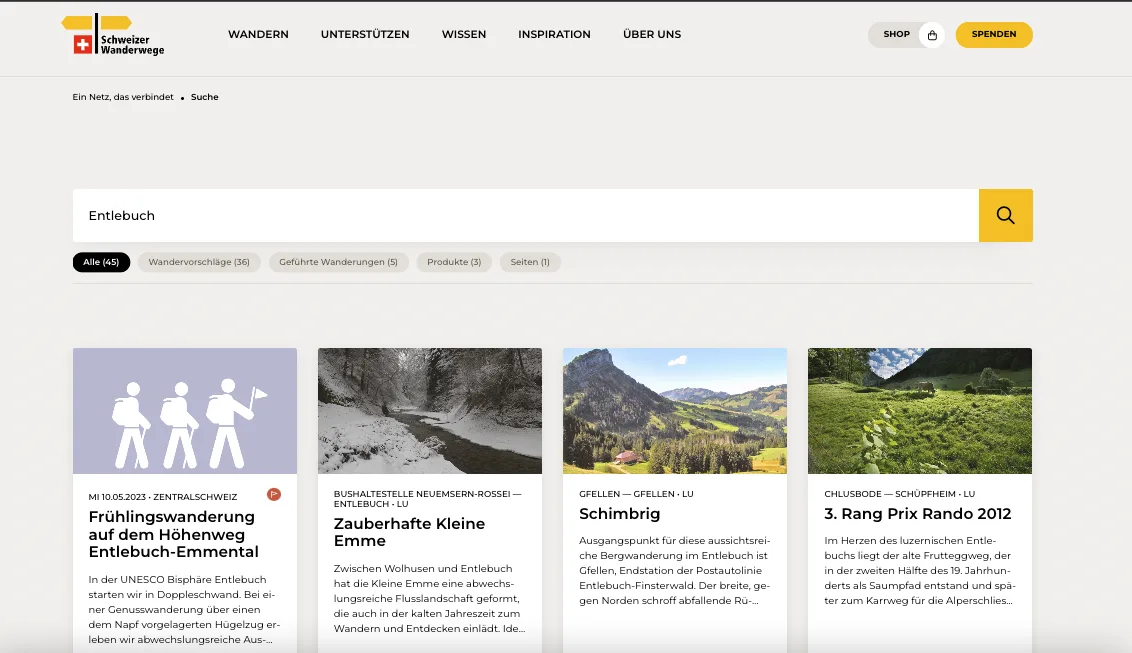
Sur la plateforme de Suisse Rando, la recherche couvre l’ensemble du site web. Deux points y sont essentiels. Premièrement, les contenus non publiés n’arrivent même pas dans l’index. Une page qui ne doit pas encore être publique n’apparaît pas non plus dans la recherche. Deuxièmement, la liste des résultats dépend du rôle : les membres connectés voient davantage que les visiteurs et visiteuses anonymes. Ainsi, la recherche ne rend rien visible qui ne doive pas l’être.
Gestion d’associations
Dans le logiciel de gestion d’un réseau de service-clubs organisé à l’échelle internationale, la même question est centrale : les membres sont rattachés à des clubs et ne doivent trouver que ce qui appartient à leur club.
Intranets
Dans nos projets d’intranet, la recherche est intégrée dès le départ.
La partie difficile : les autorisations
Les autorisations ont été la partie la plus laborieuse, car il existe de nombreux cas particuliers. Nous enregistrons donc les rôles dans Solr et vérifions à chaque requête si un objet est visible pour la personne connectée. Un exemple tiré de l’intranet : tout le monde ne peut pas voir tous les contrats, mais chacun et chacune voit ceux qu’il ou elle a créés. Représenter proprement de tels cas mixtes, c’est là le vrai travail.
Ce qui plaide pour Solr
- Le comportement de recherche se configure dans une large mesure et s’adapte aux données de chaque projet.
- Solr est spécialisé dans la recherche et laisse de côté tout ce qu’une base de données sait faire par ailleurs. C’est précisément pour cela qu’il est rapide pour indexer et pour livrer les résultats.
- Développer soi-même les mots vides, les formes des mots, la tolérance aux erreurs et le classement serait un projet en soi. Avec Solr, tout cela est inclus d’origine.
- Open source : Solr n’entraîne aucun coût de licence, et l’exploitation se fait sur notre propre infrastructure.
Pour les plateformes comportant de nombreux types de contenu et des autorisations fines, c’est la combinaison qui a fait ses preuves chez nous.
 Rédigé par
Brandon Hargrave
Senior Fullstack Software Developer