Solr Search: Funktionen, Integration und Einsatzbeispiele
Apache Solr ist die Volltextsuche in unserem Stack: selbst gehostet, weit konfigurierbar und schnell. Was sie kann, wo sie bei uns läuft und an welcher Stelle es knifflig wurde.
Eine Suche, die nichts findet, ist ärgerlicher als gar keine Suche. In unseren Plattformen steckt deshalb keine Datenbankabfrage, die Wörter vergleicht, sondern eine eigenständige Suchmaschine: Apache Solr.
Was Solr Search ist
Solr ist eine Suchplattform auf Basis von Apache Lucene. Wir haben die Open-Source-Anwendung in unseren Stack eingebunden und setzen sie projektübergreifend ein.
Solr läuft als eigenständige Anwendung in einer eigenen Docker-Instanz auf unserer Infrastruktur. Es gehen also keine Daten aus den Projektdatenbanken an Dritte, auch Personendaten bleiben im System.
Steht die Instanz, werden die Datenbanken der einzelnen Projekte angebunden; sie liefern die Inhalte für den Index. Welche Objekte durchsuchbar sind, wird pro Projekt definiert: Personen, Verträge, Dokumente, Seiten. Auch die Trefferdarstellung legen wir pro Objekttyp fest: bei einem Vertrag stehen andere Felder im Vordergrund als bei einer Person.
Was Solr ab Werk mitbringt
Solr durchsucht die angebundenen Daten wie eine erweiterte Volltextsuche. Diese Funktionen sind ohne Zusatzaufwand dabei:
- Rangfolge der Treffer nach Häufigkeit und Genauigkeit des Suchworts
- Wortformen: Wer «Wörter» sucht, findet auch «Wort»
- Umlaut-Toleranz: Eingaben ohne Umlaut finden auch Treffer mit Umlaut
- Toleranz gegenüber Tippfehlern und unvollständigen Eingaben
- Stoppwörter: Füllwörter wie «wie kann ich» fallen aus der Auswertung, gesucht wird nach dem Rest
- Schnelle Indexierung, damit neue Inhalte sofort auffindbar sind
- Stabile Antwortzeiten auch bei vielen gleichzeitigen Anfragen
Was wir ergänzt haben
- Rangfolge nach Titel: Steht das Suchwort im Titel eines Objekts, rutscht der Treffer nach oben
- Sprachtrennung: Resultate erscheinen nur in der aktiven Sprache
- Trefferanzeige nach Berechtigungsrolle
Die Liste ist nicht abschliessend, für einzelne Projekte bauen wir weitere Funktionen dazu.
Dokumente durchsuchbar machen
Dazu kommt Apache Tika. Der Parser liest Text aus Dateien und macht damit auch deren Inhalt auffindbar: Word, Excel, PDF und weitere Formate. Das lohnt sich überall dort, wo Formulare, Merkblätter oder Reglemente als Datei hängen und die Leute den Inhalt suchen, nicht den Dateinamen.
Wo Solr bei uns im Einsatz ist
Schweizer Wanderwege
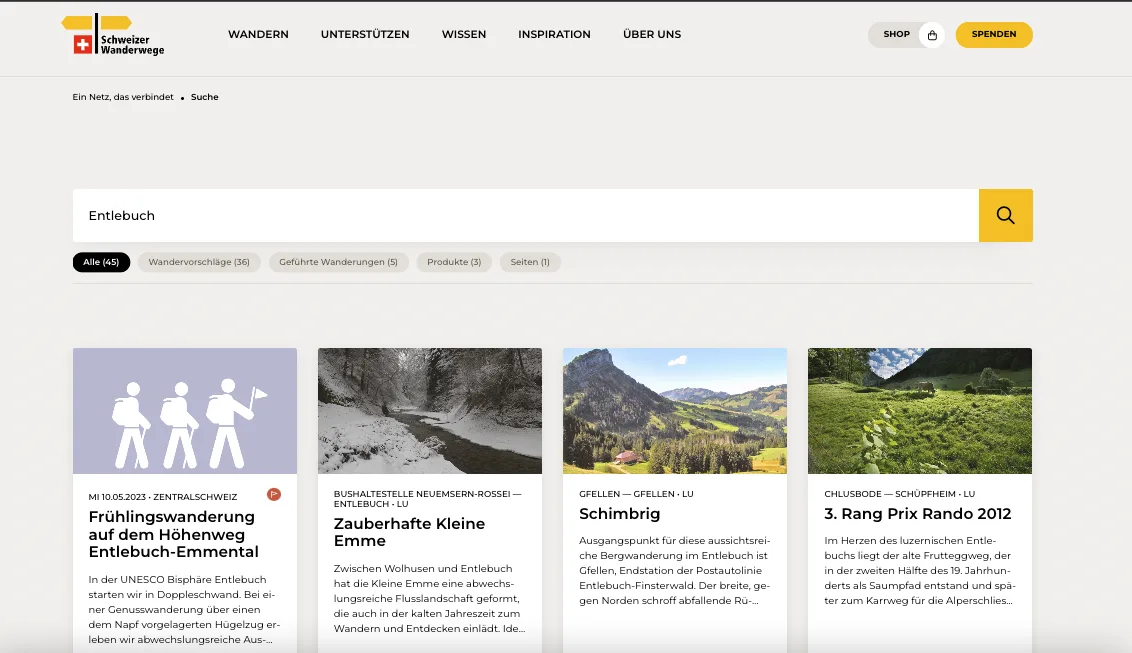
Auf der Plattform der Schweizer Wanderwege deckt die Suche die gesamte Website ab. Zwei Punkte sind dort zentral. Erstens landen unveröffentlichte Inhalte gar nicht erst im Index. Eine Seite, die noch nicht öffentlich sein soll, taucht auch in der Suche nicht auf. Zweitens richtet sich die Trefferliste nach der Rolle: Eingeloggte Mitglieder sehen mehr als anonyme Besucherinnen. So wird über die Suche nichts sichtbar, was nicht sichtbar sein soll.
Verbandsverwaltung
In der Verwaltungssoftware eines international organisierten Service-Club-Netzwerks steht dieselbe Frage im Zentrum: Die Mitglieder sind einzelnen Klubs zugeordnet und sollen nur finden, was zu ihrem Klub gehört.
Intranets
In unseren Intranet-Projekten ist die Suche von Anfang an eingebaut.
Der schwierige Teil: Berechtigungen
Die Berechtigungen waren der aufwendigste Teil, weil es viele Sonderfälle gibt. Wir speichern die Rollen deshalb in Solr und prüfen bei jeder Anfrage, ob ein Objekt für die angemeldete Person sichtbar ist. Ein Beispiel aus dem Intranet: Nicht alle dürfen alle Verträge sehen, die selbst erstellten aber schon. Solche Mischfälle sauber abzubilden, ist die eigentliche Arbeit.
Was für Solr spricht
- Das Suchverhalten lässt sich weitgehend konfigurieren und pro Projekt auf den Datenbestand einstellen.
- Solr ist auf Suche spezialisiert und lässt weg, was eine Datenbank sonst noch kann. Genau deshalb ist es beim Indexieren und beim Ausliefern der Treffer schnell.
- Stoppwörter, Wortformen, Fehlertoleranz und Ranking selbst zu bauen, wäre ein Projekt für sich. Bei Solr sind sie ab Werk dabei.
- Open Source: Für Solr fallen keine Lizenzkosten an, und der Betrieb läuft auf unserer eigenen Infrastruktur.
Für Plattformen mit vielen Inhaltstypen und feinen Berechtigungen ist das die Kombination, die sich bei uns bewährt hat.
 Geschrieben von
Brandon Hargrave
Senior Fullstack Software Developer